Nous recommandons d'appliquer une règle de cycle de vie (y compris Intelligent Tiering) pour les buckets S3 afin de limiter les coûts. Agissez avec prudence et assurez-vous de mettre en œuvre les bonnes règles de cycle de vie.
Les sous-titres sont disponibles en anglais, français et espagnol. Cliquez ici pour obtenir la masterclass complète.
Comment identifier?
Vous pouvez identifier les buckets S3 qui ont besoin de règles de cycle de vie en utilisant les méthodes suivantes :
Dans notre Rapport d'optimisations des coûts, vérifiez la section S3_Storage_Classes. Les buckets listés sont supérieurs à 1 To et utilisent principalement le niveau le plus cher Standard.
Dans la console AWS, allez dans le service S3, puis sélectionnez la section Buckets. Cliquez sur "Voir le tableau de bord Storage Lens" en haut.
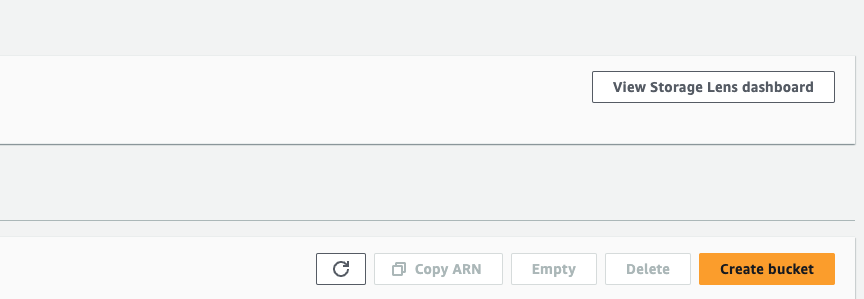
Allez à l'aperçu Top N en bas et modifiez le nombre à 10.
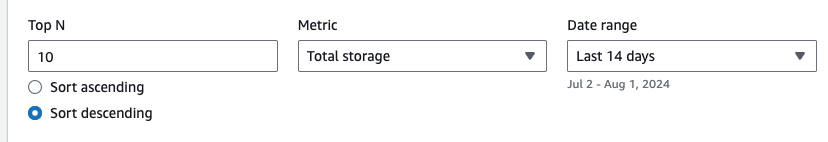
Examinez la liste de vos buckets, leur stockage total et les tendances.
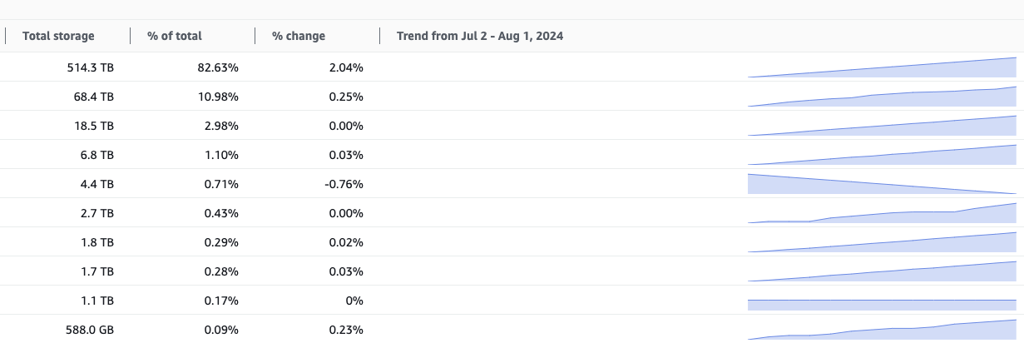
Chaque bucket S3 de plus de 1 To doit être examiné.
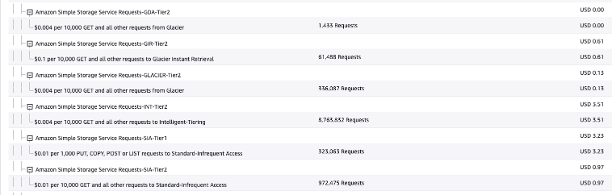
Dans la console AWS, allez à Facturation, puis sélectionnez Factures. Choisissez Service de stockage simple et une région. Recherchez la ligne des demandes.
Comment corriger ?
Dans la console AWS, allez à S3, puis sélectionnez Buckets.
Cliquez sur un nom de bucket.
Reconnaissez les données dans chaque dossier et filtrez par la dernière date de modification colonne.
Allez à Propriétés pour vérifier si la versioning des buckets est activée.
Allez à Métriques pour voir la tendance de votre bucket (taille du bucket et nombre d'objets).
Allez à Gestion pour examiner les règles de cycle de vie existantes et les règles de réplication.
Posez-vous les questions suivantes :
1. Ai-je besoin de ces données ?
Si le bucket est totalement ou partiellement inutile, la suppression est nécessaire.
Suppression totale :
Pour supprimer un bucket entier, videz-le d'abord. Dans la liste des Buckets, sélectionnez le bucket, cliquez sur Vider, et confirmez.
Retournez aux Buckets liste, sélectionnez le seau, cliquez sur Supprimer, et confirmez.
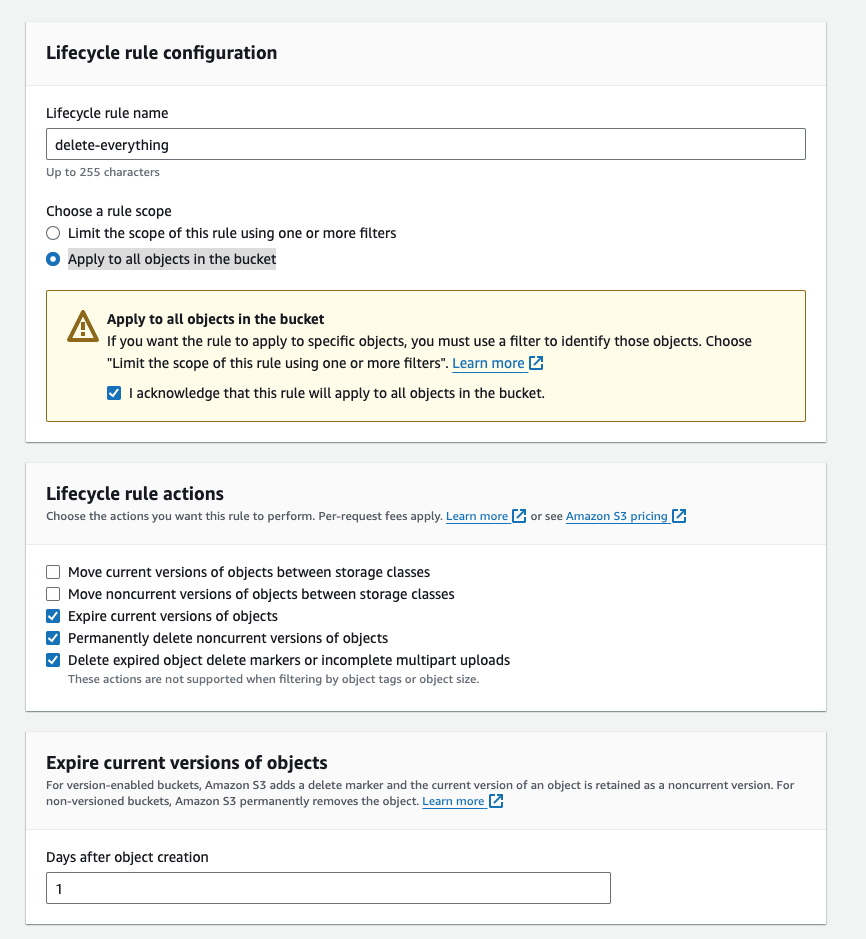
Si la suppression prend trop de temps en raison de nombreux objets, créez une règle de cycle de vie:
Cliquez sur le nom du seau, allez à Gestion, et cliquez Créer une règle de cycle de vie.
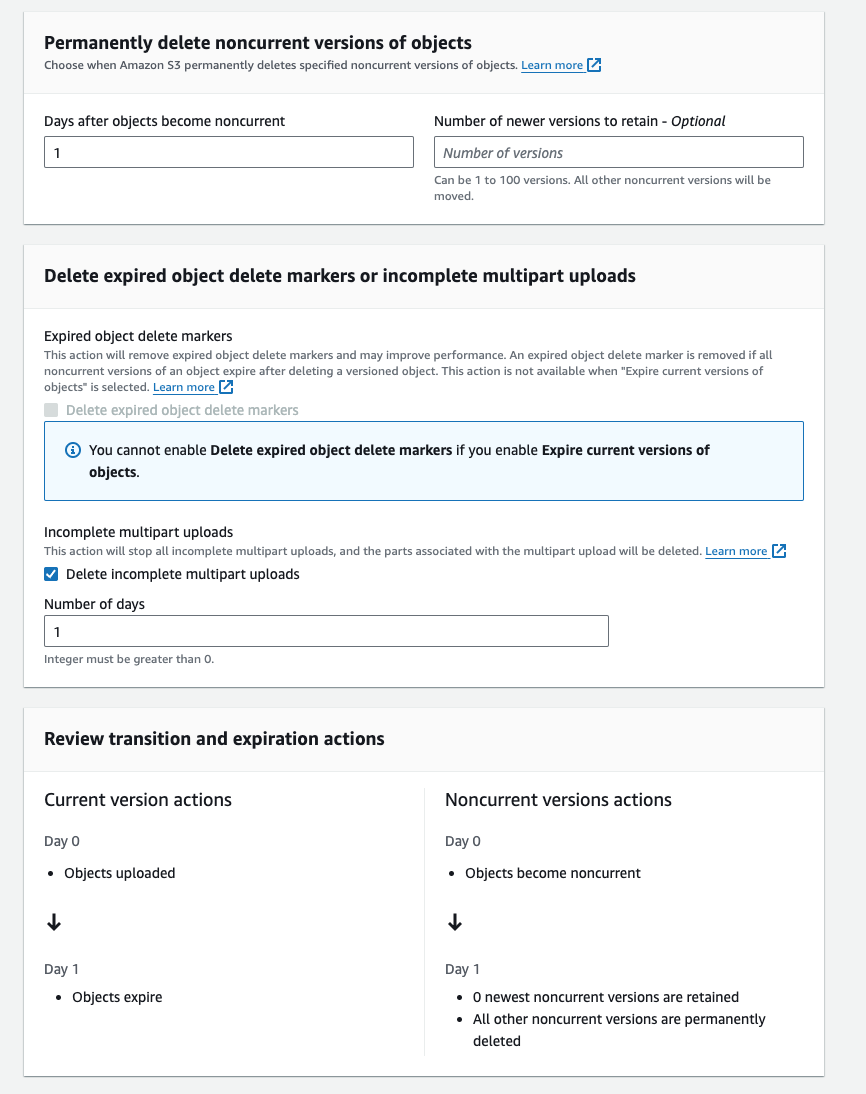
Configurez la règle comme indiqué ci-dessous et cliquez Créer une règle.
La suppression prendra 1-2 jours. Surveillez les progrès dans la section Métriques.
Suppression partielle :
Pour supprimer des dossiers ou objets spécifiques, sélectionnez-les et cliquez sur Supprimer.
Si la suppression prend trop de temps, créez une règle de cycle de vie avec un préfixe (par exemple, logs/2012/).
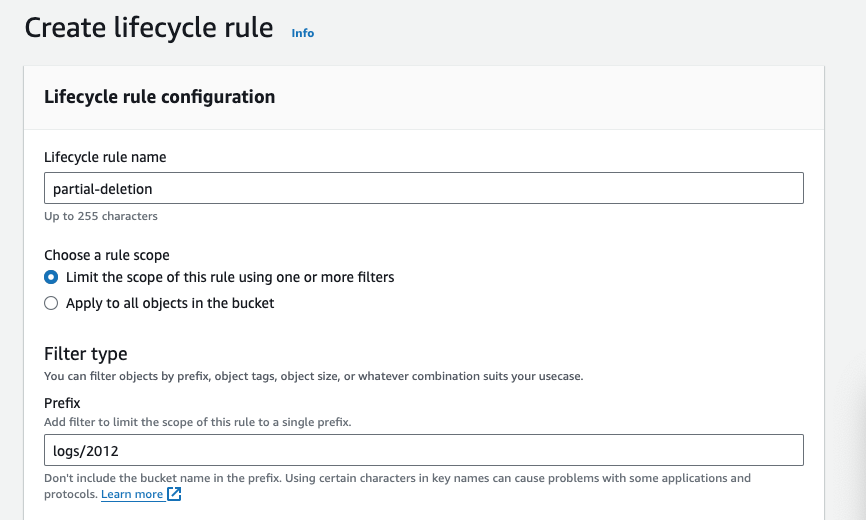
Cet exemple modifiera toutes les données dans le dossier 2012 dans le dossier logsde votre seau. Veuillez créer une règle de cycle de vie par préfixe. Mais un préfixe peut être utilisé pour supprimer plusieurs dossiers. Si vous mettez logs/201 dans le préfixe, cela devrait supprimer les logs de 2010 à 2019 (tous les dossiers commençant par 201 dans le dossier logs).
Si vous souhaitez simplement supprimer toutes les autres versions des objets, vous pouvez également ajouter 1 dans Nombre de versions plus récentes à conserver.
Vous pouvez également automatiser ces règles via CloudFormation, Terraform, etc.
Cela devrait prendre 1-2 jours pour supprimer tous les objets. Vous devriez voir les progrès dans la section Métriques.
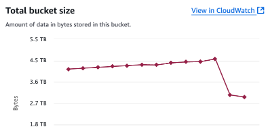
2. Si j'ai besoin de ces données, alors combien de temps ?
Déterminez la durée de conservation des données avec votre équipe (par exemple, 10 jours, 3 mois, 3 ans). Par exemple, le compartiment de journaux doit avoir une règle d'expiration qui dépendra de votre règle de conservation des données. Cela pourrait être 10 jours, 3 mois, 3 ans ?
Créez une règle de Cycle de Vie et ajustez la section Jours en conséquence. Pour une conservation d'un an, vous devriez mettre cela :
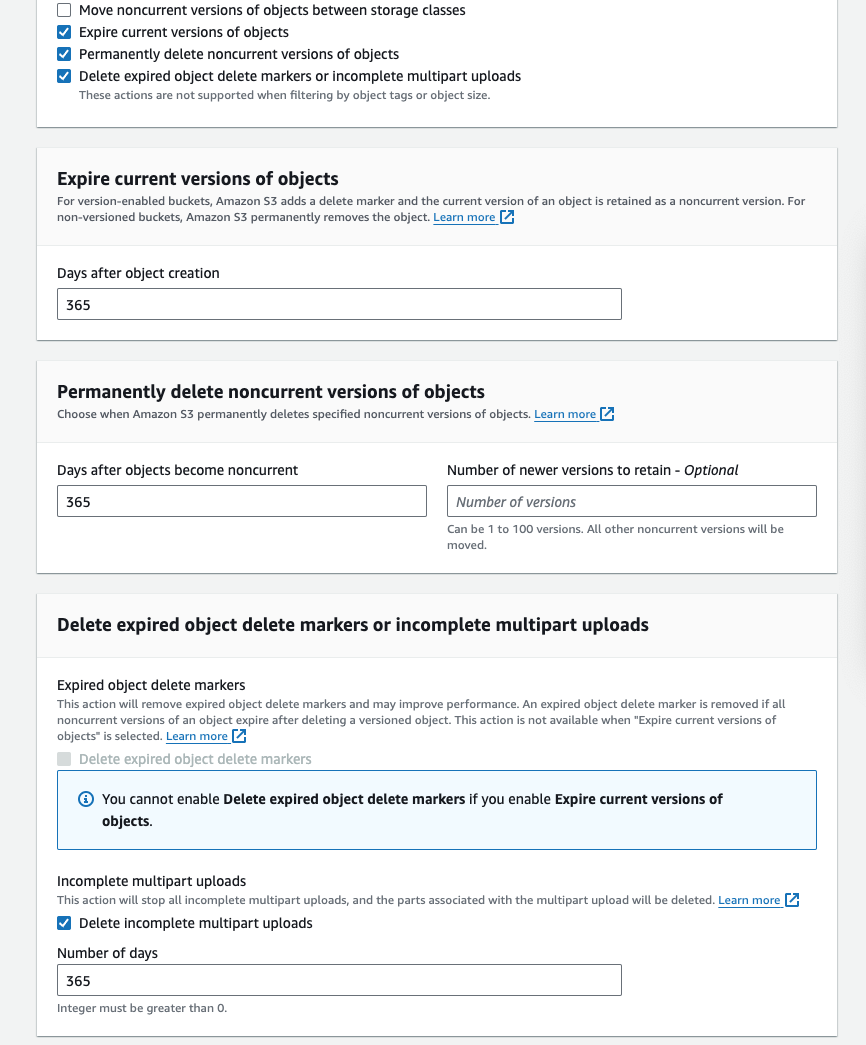
3. Si j'ai besoin de ces données de manière permanente, alors à quelle fréquence dois-je y accéder ?
Si vous conservez des données à des fins d'archivage, envisagez les classes de stockage en fonction de la fréquence d'accès.
Veuillez n'archiver que les objets que vous n'êtes pas censé récupérer fréquemment, sinon cela sera plus coûteux et vous devrez peut-être attendre pour obtenir vos données.
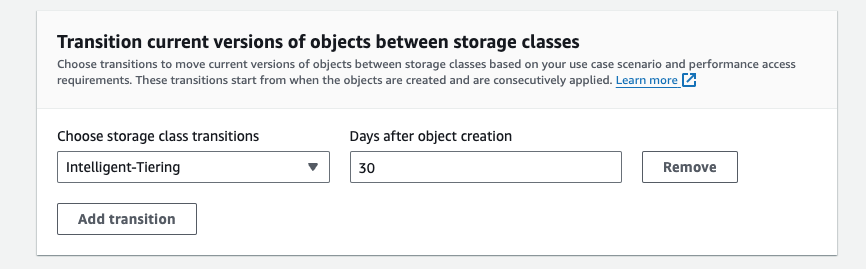
Vous avez de nombreuses classes différentes, mais la transition classique serait celle-ci :
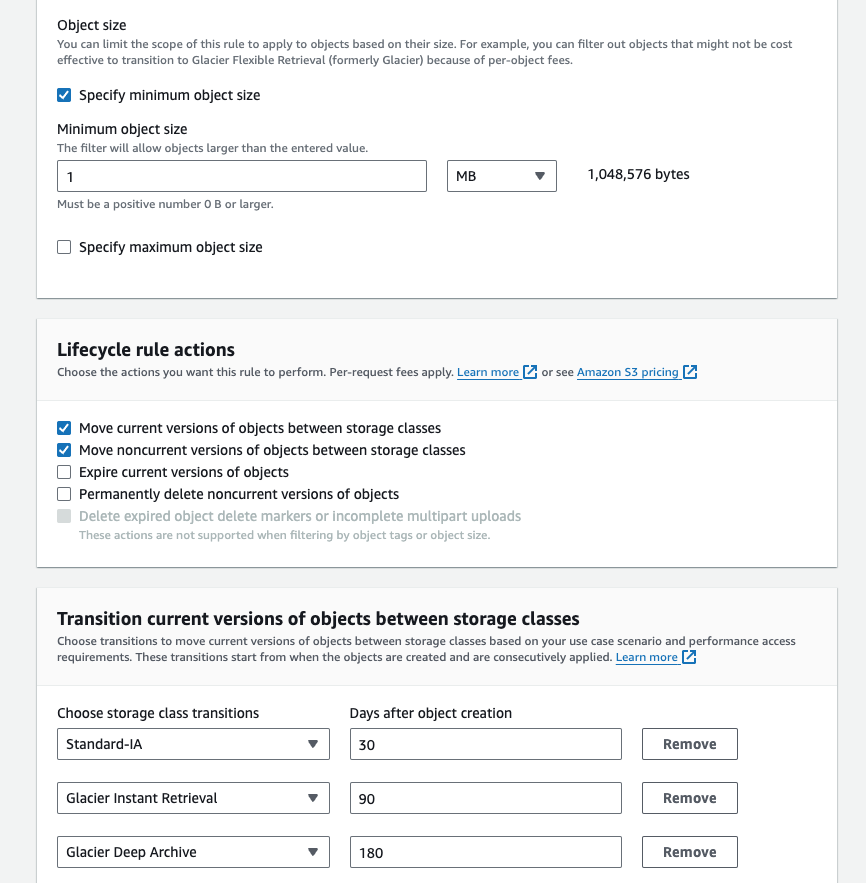
Transitionnez les objets vers des classes de stockage rentables, en veillant à ce qu'il y ait une taille d'objet minimale pour éviter des coûts de transition inutiles.
Appliquez les mêmes transitions aux versions non courantes.
Si vous n'êtes pas sûr de l'utilisation des données, utilisez Intelligent-Tiering pour déplacer automatiquement les objets vers le bon type de stockage.
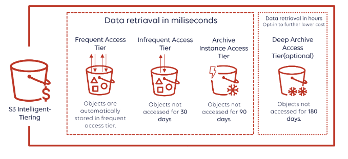
Classes de stockage S3
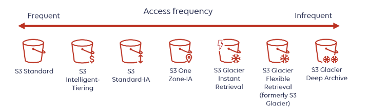
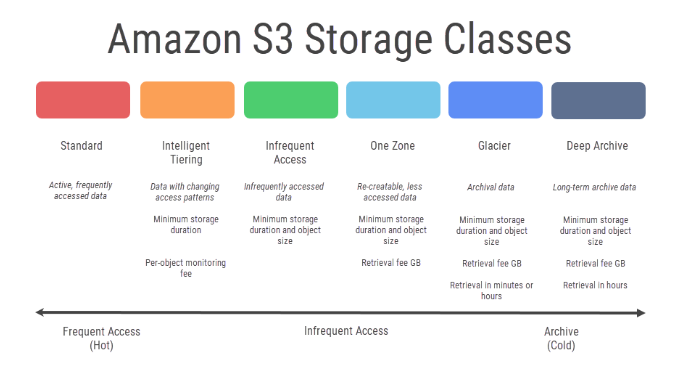
S3 fournit différents niveaux de fiabilité et de disponibilité à travers ses classes de stockage.
Chaque classe de stockage a une structure de coût différente et des garanties sur la rapidité d'accès à vos données. Certaines d'entre elles ont même une durée de stockage minimale.
S3 Standard : Conçu pour les données fréquemment accessibles.
S3 Intelligent-Tiering : Données avec des modèles d'accès changeants ou inconnus.
S3 Standard-IA : Conçu pour des données à long terme, peu fréquemment accessibles.
S3 One Zone-IA : Conçu pour des données à long terme, peu fréquemment accessibles, non critiques.
S3 Réduction de redondance : Données fréquemment accessibles, non critiques.
S3 Glacier Instant Retrieval : Conçu pour des données d'archive accessibles une fois par trimestre avec un accès instantané en millisecondes.
S3 Glacier Flexible Retrieval (anciennement Glacier) : Conçu pour des données critiques archivées peu fréquemment accessibles.
S3 Glacier Deep Archive : Archivage de données à long terme avec des temps de récupération dans les 12 heures.
Vous pouvez également analyser tous vos buckets avec S3 analytics.
Si la ressource est provisionnée automatiquement via IaC (comme CloudFormation ou Terraform), mettez à jour le code correspondant pour refléter les changements.